Belakangan ini makin banyak pengguna teknologi, programmer, maupun pegiat elektronika yang mulai melirik Local AI alias menjalankan model kecerdasan buatan (LLM) langsung di komputer pribadi di rumah. Alasannya simpel: biaya langganan AI cloud makin terasa berat kalau dipakai riset dan ngoding seharian, belum lagi soal batasan kuota harian dan kekhawatiran privasi data.
Kabar baiknya, menjalankan AI sendiri di rumah sekarang tidak lagi wajib pakai perintah terminal yang bikin pusing atau setup environment Python yang rawan error. Lewat panduan praktis yang dibagikan Jerry James di GPU Partner (dan ramai dibahas di Hacker News), kamu bisa menyulap PC rumahan menjadi “ChatGPT pribadi” dalam waktu 10–15 menit saja menggunakan Unsloth Desktop, serta model open-weight terbaru seperti Qwen3.8-27B dan Inkling 2 Mini—bahkan bisa diakses rame-rame oleh satu keluarga lewat jaringan Wi-Fi/LAN rumah!
Apa Saja yang Dibutuhkan untuk Menjalankan AI Lokal?
Syarat utamanya sangat ringkas dan tidak butuh langganan cloud apa pun:
- PC Windows, macOS, atau Linux dengan GPU yang memadai: Semakin besar kapasitas VRAM kartu grafis kamu, semakin besar ukuran parameter model yang bisa dijalankan dan semakin panjang memori percakapannya (context window). Pengguna Mac dengan unified memory besar juga bisa menjalankannya menggunakan format MLX.
- Aplikasi Unsloth Desktop: Aplikasi gratis dan open-source yang bertugas menjalankan sekaligus menyajikan antarmuka chat AI secara lokal tanpa perlu ribet setting terminal.
- File Model AI Terkuantisasi (Quantized): Dipilih dan diunduh langsung dari dalam aplikasi menyesuaikan kapasitas VRAM GPU.
Mengenal Kuantisasi dan Memilih Model Sesuai Kapasitas VRAM
Model AI versi penuh umumnya berukuran raksasa—misalnya Qwen3.8-27B versi 16-bit aslinya memakan memori sekitar 56 GB, yang jelas tidak muat di kartu grafis PC rumahan. Di sinilah teknik kuantisasi (quantization) berperan penting.
Kuantisasi bekerja dengan cara mengompresi bobot (weights) model dari presisi tinggi ke presisi yang lebih rendah (seperti 8-bit, 4-bit, atau 2-bit), mirip seperti menurunkan kedalaman bit warna pada gambar agar ukuran filenya menyusut drastis namun tetap nyaman dipakai.
Panduan Cepat Ukuran VRAM vs Rekomendasi Model
- VRAM Kecil (8–12 GB — misal RTX 3060 12GB, RTX 5060 8GB, RTX 5070 12GB): Cocok untuk model
Qwen3.5-9BatauGemma 4 12B(kuantisasiUD-Q4_K_SatauQ4_K_M) dengan konteks 8K–16K. - VRAM Menengah (16 GB — misal RTX 5060 Ti 16GB, RTX 5070 Ti, RTX 5080): Nyaman menjalankan
Qwen3-14Bataugpt-oss-20b(kuantisasiQ4_K_M/Q5_K_M) dengan konteks 16K–32K. - VRAM Besar (24 GB — misal RTX 3090, RTX 4090, RX 7900 XTX): Sanggup melibas
Qwen3-Coder-30B,Gemma 4 26B/31B,Qwen3.8-27B, hingga Inkling 2 Mini (UD-Q4_K_M/Q4_K_S) dengan konteks 16K–32K. - VRAM Ekstra Besar (32 GB+ — misal RTX 5090, RTX PRO 4500+): Bisa memakai kuantisasi kualitas tinggi
UD-Q4_K_XLatauQ6_KpadaQwen3.8-27B,Inkling 2 Mini, danQwen3.6-35Bdengan context window lega hingga 64K–128K+.
Sekilas Tentang Pendatang Baru: Inkling 2 Mini
Salah satu model yang mencuri perhatian di kelas menengah-atas adalah Inkling 2 Mini (rilis 17 November 2026 oleh Thinking Machines Lab) dengan 26,4 miliar parameter, lisensi Apache 2.0, dukungan penglihatan (vision), dan jendela konteks raksasa hingga 1 juta token. Versi rekomendasi Unsloth (UD-Q4_K_XL) berukuran 17,6 GB, yang artinya muat di GPU 24 GB atau 32 GB (dan versi 2-bit sekitar 10–11 GB bahkan bisa dicoba di kartu 12 GB). Sementara kakaknya, Inkling 2 Small (594B parameter, file terkecil 171,7 GB), khusus ditujukan untuk mesin unified-memory kelas berat seperti Mac Studio 256 GB.
Langkah Mudah Setup Unsloth Desktop & Berbagi ke Satu Rumah via LAN
Proses instalasi dan konfigurasinya terbagi menjadi empat tahap singkat:
- Pasang Unsloth Desktop: Unduh dan instal aplikasinya seperti software desktop biasa. Saat pertama kali dibuka, antarmukanya langsung siap tanpa konfigurasi CLI.
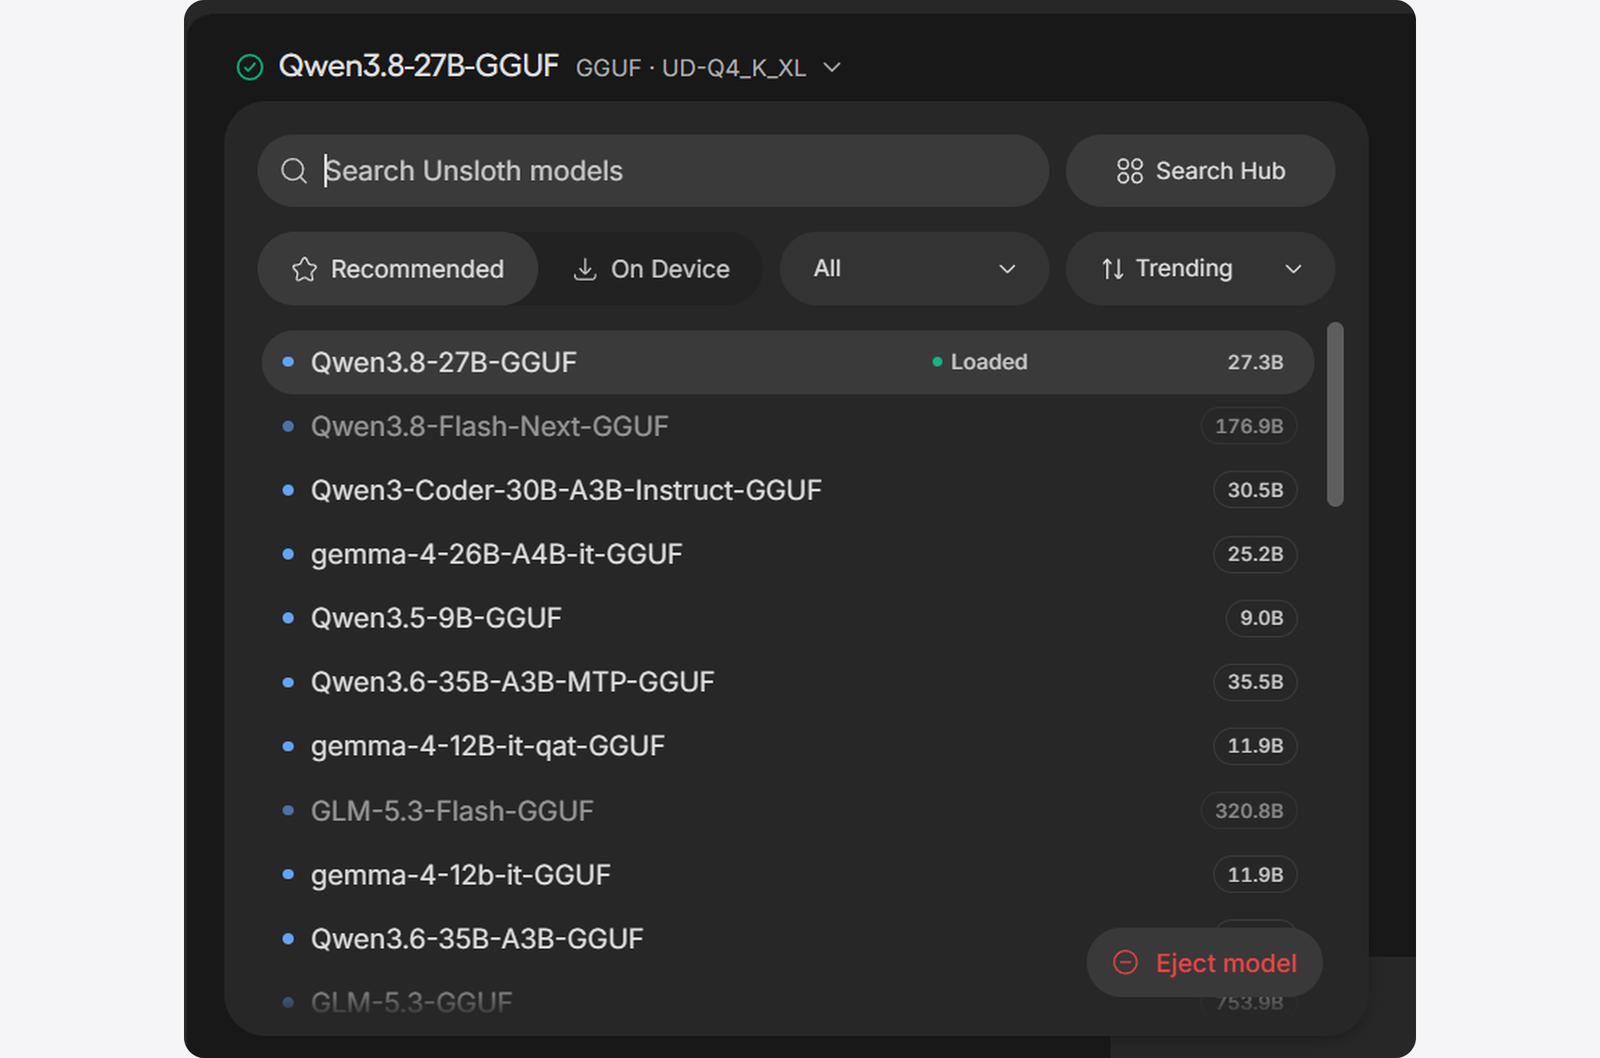
- Unduh Model yang Tepat: Klik menu dropdown pemilihan model di pojok kiri atas. Pilih model rekomendasi seperti
Qwen3.8-27Batau cariInkling 2 Mini, lalu pilih varian kuantisasi (misalUD-Q4_K_XL) sesuai kapasitas VRAM kartu grafis kamu. - Atur Context Size: Setelah selesai mengunduh, klik ikon gerigi di sebelah kanan nama model untuk menentukan ukuran konteks (bisa dibiarkan Auto jika belum yakin, atau diset manual seperti 128K jika VRAM tersisa masih lega).
- Aktifkan LAN Sharing untuk Keluarga: Masuk ke menu Settings (ikon gerigi di kiri bawah) → tab Remote & LAN. Atur dulu kata sandi pada bagian Remote password agar tombol Start pada kartu LAN access aktif. Setelah dinyalakan, Unsloth Desktop akan memberikan alamat IP lokal yang bisa dibuka dari browser HP atau laptop anggota keluarga lain di rumah (login menggunakan username
unslothdan password yang baru dibuat).
Sebagai catatan, selama layanan ini dibagikan lewat LAN, PC utama tentu harus dalam kondisi menyala dan menjalankan aplikasi Unsloth Desktop.
Ide Pengembangan & Eksperimen Kreatif
Untuk para maker dan penggemar otomasi rumahan, punya server AI lokal di jaringan LAN membuka banyak peluang eksperimen seru tanpa perlu bayar token API:
- Asisten Bengkel Offline untuk Baca Datasheet & Debugging Kode ESP32/Arduino: Saat ngoprek di bengkel yang sinyalnya susah atau sedang offline, kamu bisa menyalin potongan datasheet IC, log error compiler Arduino/PlatformIO, atau skrip Python ke Local AI di LAN untuk dianalisis cepat tanpa mengirim kode proyek internal ke server luar.
- Integrasi dengan Home Assistant atau Telegram Bot Lokal: Manfaatkan endpoint API lokal yang disediakan Unsloth di jaringan LAN untuk menghubungkan Home Assistant atau bot Telegram pribadi sebagai asisten perangkum catatan harian, pembaca log sensor IoT, atau pengontrol perangkat pintar berbasis perintah bahasa alami.
- Uji Coba Pengukuran Konsumsi Daya Real-Time (Wattmeter PC): Khusus untuk pegiat kelistrikan dan PLTS rumahan, coba pasang smart plug pengukur daya (seperti modul PZEM atau colokan pintar Tasmota/ESPHome) di PC server AI kamu. Bandingkan lonjakan daya GPU saat memproses prompt model 9B vs 27B, lalu hitung apakah pasokan baterai LiFePO4/inverter di rumah sanggup menopangnya saat mati lampu.
Link Penting & Dokumentasi
- Dokumentasi Resmi Unsloth Desktop: unsloth.ai/docs/desktop
- Panduan Pengaturan LAN Access Unsloth: unsloth.ai/docs/desktop/lan
- Repositori Model Qwen3.8-27B GGUF: huggingface.co/unsloth/Qwen3.8-27B-GGUF
- Halaman Model Inkling 2 Mini: huggingface.co/thinkingmachines/Inkling-2-Mini
Yuk Diskusi!
Kalau kamu sudah pernah nyoba menjalankan AI lokal di PC atau laptop sendiri, model mana yang menurutmu paling pas antara kecepatan dan kepintarannya di GPU kelas menengah (8–16 GB VRAM)? Dan kalau sudah jalan di jaringan lokal rumah, tugas apa yang paling sering kamu lempar ke AI lokalmu? Yuk share di kolom komentar!
Sumber & Referensi
Disarikan dari panduan Jerry James melalui artikel A beginner’s guide to Local AI with Inkling, Qwen, and Unsloth di GPU Partner beserta dokumentasi resmi Unsloth Desktop.